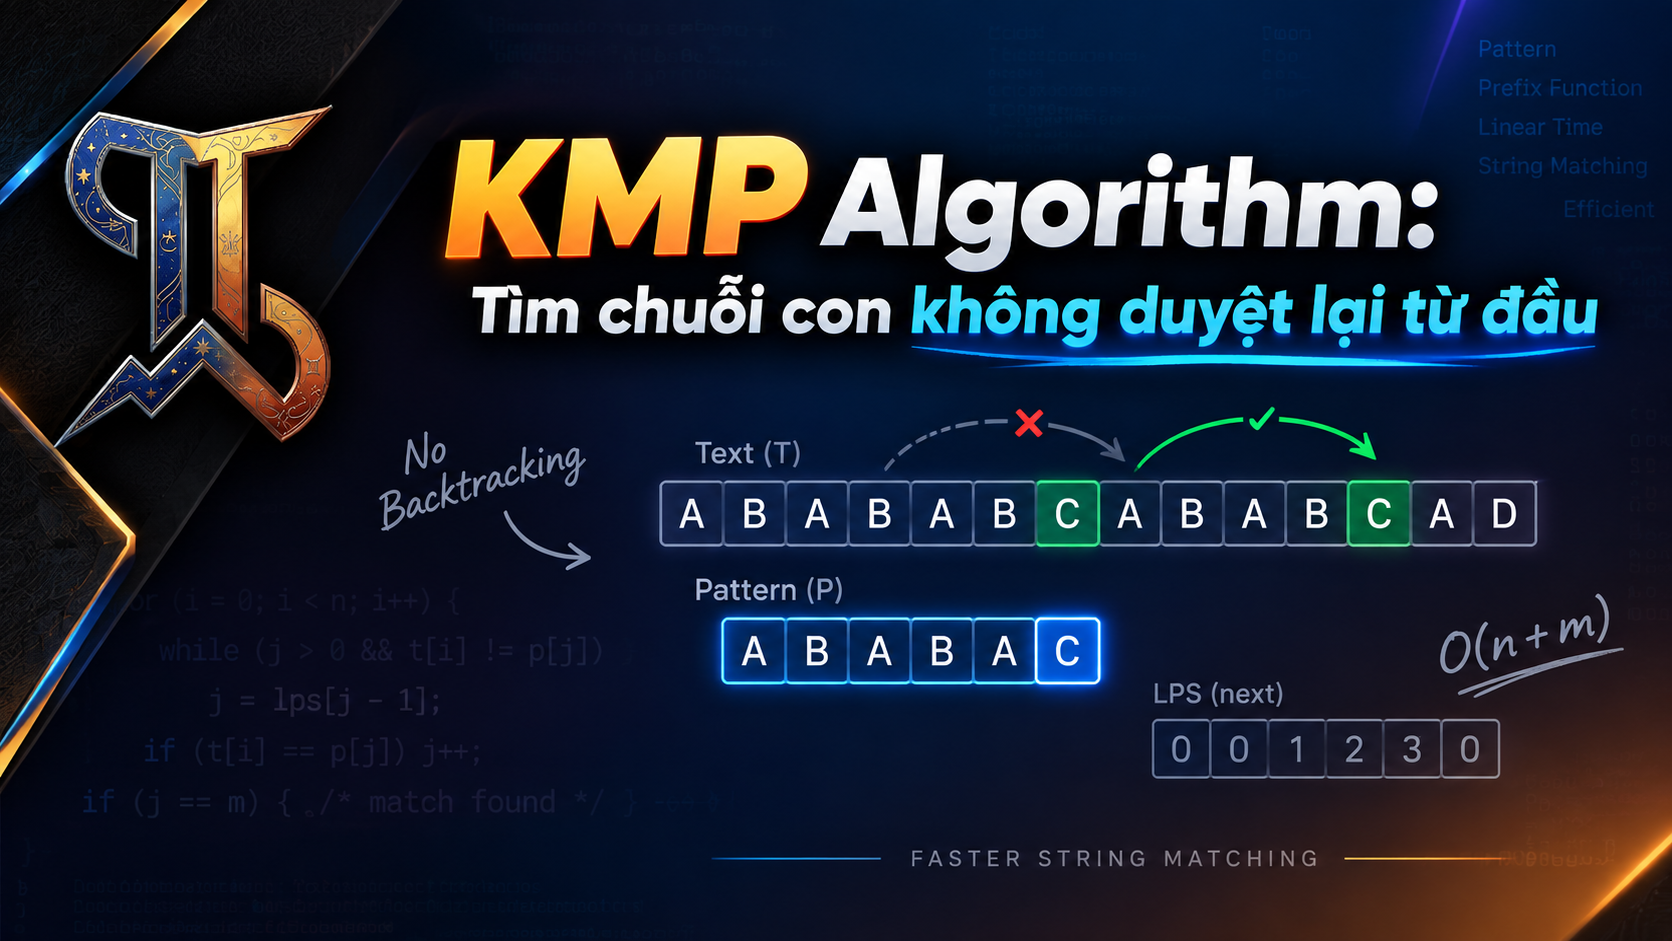
Cần tìm vị trí pattern xuất hiện trong text. Kết quả là index 10 nếu dùng zero-based indexing.
Brute Force
Thuật toán naive thử từng điểm bắt đầu:
Worst-case xảy ra với dữ liệu lặp:
Nhiều ký tự A bị so sánh lại. Complexity có thể là:
KMP dùng thông tin từ phần đã match để không làm lại toàn bộ công việc.
Comments
Ý tưởng cốt lõi
Giả sử đã match một prefix dài j của pattern rồi gặp mismatch:
Ta đã biết các ký tự trước đó bằng pattern[0..j). Nếu trong đoạn đã match có một suffix cũng là prefix của pattern, suffix đó vẫn là một partial match hợp lệ.
Thay vì đặt j = 0, KMP đặt:
Con trỏ text i chưa tăng và cũng không lùi. Ta thử tiếp với prefix dài nhất còn có thể đúng.
Prefix, Suffix và “Proper”
Với chuỗi ABAB:
Prefixes: A, AB, ABA, ABAB.
Suffixes: B, AB, BAB, ABAB.
Longest proper prefix cũng là suffix: AB, length 2.
“Proper” nghĩa là không lấy toàn bộ chuỗi. Nếu cho phép toàn bộ chuỗi, mọi prefix tự match chính nó và bảng không giúp fallback.
LPS là gì?
lps[i] là độ dài của longest proper prefix của pattern[0..i] đồng thời là suffix của chính đoạn đó.
Với pattern:
Giải thích:
pattern[0..3] = ABAB: border dài nhất là AB, nên lps[3] = 2.
pattern[0..8] = ABABCABAB: border dài nhất là ABAB, nên lps[8] = 4.
Prefix-function, failure-function và LPS table thường mô tả cùng ý tưởng với indexing/convention hơi khác nhau.
Xây bảng LPS
Duy trì:
i: vị trí đang cần tính LPS.
length: độ dài border candidate hiện tại.
Điểm khó nhất: khi mismatch và length > 0, không tăng i. Ta thử border ngắn hơn của chính border hiện tại.
Vì sao length = lps[length - 1]?
Nếu border dài length thất bại ở ký tự tiếp theo, candidate tiếp theo không thể dài tùy ý. Nó phải vừa:
Là prefix của pattern.
Là suffix của phần đã match.
Border lớn nhất nhỏ hơn hiện tại đã được lưu ở lps[length - 1]. Đây là “fallback chain”.
Tìm match đầu tiên
Hai con trỏ làm gì?
i trỏ vào text và không bao giờ giảm.
j là số ký tự pattern đã match.
Khi mismatch:
Đây chính là ý “không duyệt lại text từ đầu”.
Tìm tất cả matches, kể cả overlap
Với:
Sau full match, gán j = lps[j - 1] thay vì 0 để giữ overlap có thể có.
Wrapper cho JavaScript String
Nếu muốn semantics giống index theo UTF-16 code unit của JavaScript:
Nhưng split("") tách surrogate pair. Cách này trả index tương thích String.prototype.indexOf, không phải index theo ký tự người dùng nhìn thấy.
Unicode, Code Point và Grapheme
JavaScript string[index] làm việc theo UTF-16 code units. Một emoji có thể chiếm hai code units; grapheme như emoji gia đình có nhiều code points.
Search theo code point
Index trả về là code-point index, không phải UTF-16 offset.
Search theo grapheme
Nếu UI cần highlight original string, phải lưu mapping từ token/grapheme index về UTF-16 start/end offset. Normalization và case folding có thể thay đổi độ dài, nên không lấy index trên normalized text để cắt original text một cách mù quáng.
Walkthrough Search
Với:
Sau khi match ABAB, text có D trong khi pattern mong C:
KMP giữ nguyên text position và thử xem suffix AB đã match có thể đóng vai prefix AB của pattern hay không. Nếu tiếp tục mismatch, fallback thêm. Text characters không bị quay lại so sánh từ điểm bắt đầu cũ.
Cuối cùng full pattern xuất hiện ở index 10.
Chứng minh Complexity O(n + m)
Preprocessing
Trong buildLps:
i chỉ tăng từ 1 tới m.
length có thể giảm qua fallback, nhưng mỗi lần tăng trước đó tạo “budget” cho lần giảm.
Tổng số bước là O(m).
Search
Trong search:
i không bao giờ giảm và tăng tối đa n lần.
j tăng khi match, giảm theo LPS khi mismatch.
Tổng lần tăng/giảm của j bị chặn tuyến tính.
Do đó:
KMP không đảm bảo mỗi text character chỉ được đọc đúng một lần theo nghĩa tuyệt đối của comparison count, nhưng tổng comparisons vẫn tuyến tính và text index không backtrack.
Compile Pattern để tái sử dụng
Khi tìm cùng pattern trong nhiều texts, preprocess một lần:
Điều này tránh trả cost O(m) cho mỗi document. Cần giữ representation/normalization nhất quán giữa pattern và text.
Streaming Search
KMP phù hợp khi text đến theo chunks vì state chỉ gồm:
j: prefix length hiện tại.
processed: tổng số units đã đọc.
LPS và pattern.
Chunk boundary không làm mất partial match.
Use cases:
Log stream.
Network protocol delimiter.
Large file không muốn load toàn bộ.
Token/event sequence matching.
Đừng dùng raw substring matching để parse protocol phức tạp nếu grammar/framing yêu cầu parser thực thụ.
KMP có thể tìm Sequence, không chỉ String
Generic implementation có thể tìm:
Byte pattern trong binary buffer.
Token sequence trong compiler.
Event sequence.
DNA symbols.
Array object với custom equality.
Nếu custom equality đắt, complexity theo số comparisons vẫn tuyến tính nhưng wall-clock cost phụ thuộc comparator.
Empty Pattern Semantics
Cần định nghĩa API rõ ràng:
kmpIndexOf(text, []) trả 0, giống nhiều indexOf APIs.
kmpFindAll(text, []) trong ví dụ trả [] để tránh tạo mọi boundary.
Toán học có thể coi empty pattern match ở n + 1 boundaries. Đừng để behavior vô tình khác giữa services.
KMP so với các thuật toán khác
“Siêu tốc” nên hiểu là deterministic linear worst-case, không phải luôn thắng benchmark thực tế.
Những lỗi thường gặp
Nhầm LPS là longest repeated substring bất kỳ.
Cho phép prefix bằng toàn bộ substring, quên chữ “proper”.
Khi build LPS mismatch thì tăng i quá sớm.
Search mismatch luôn đặt j = 0 và mất lợi ích KMP.
Khi j > 0 lại tăng i, bỏ qua match hợp lệ.
Sau full match đặt j = 0, bỏ lỡ overlap.
Sai lps[j] thay vì lps[j - 1].
Không định nghĩa empty pattern.
Trộn UTF-16 offsets với code-point/grapheme indices.
Normalize pattern nhưng không normalize text cùng cách.
Giả định KMP JavaScript luôn nhanh hơn native indexOf.
Dùng một-pattern KMP cho hàng nghìn patterns thay vì multi-pattern algorithm.
Testing Checklist
Empty text và empty pattern theo API contract.
Pattern dài hơn text trả -1/empty list.
Match ở đầu, giữa và cuối.
Không có match.
Text và pattern giống nhau.
Repeated characters như AAAAA/AAA.
Overlapping matches.
Pattern có nhiều fallback levels.
Pattern length 1.
Unicode NFC/NFD theo normalization policy.
Emoji/code point/grapheme semantics.
Mapping highlight về original UTF-16 offsets.
Match đi qua hai streaming chunks.
Nhiều matches trong một chunk.
Randomized comparison với trusted indexOf cho UTF-16 mode.
Large repetitive adversarial input hoàn thành tuyến tính.
Production Checklist
Xác định semantics: UTF-16, code point, grapheme, byte hay token.
Định nghĩa case/Unicode normalization.
Dùng built-in trước nếu không có yêu cầu đặc biệt.
Precompute LPS khi reuse pattern.
Giữ indices nhất quán với API/UI.
Handle empty pattern rõ ràng.
Support overlap nếu use case cần.
Cap input nếu dữ liệu untrusted và memory có giới hạn.
Benchmark với corpus thật và native alternative.
Dùng streaming state cho file/network lớn.
Chọn Aho–Corasick nếu có nhiều patterns.
Theo dõi latency và allocation, không chỉ Big-O.
Kết luận
KMP không “đoán” chỗ nhảy. Nó preprocess pattern thành LPS table, mô tả cấu trúc prefix-suffix của từng prefix. Khi mismatch, KMP chuyển j tới border dài nhất còn hợp lệ, giữ nguyên i và tái sử dụng toàn bộ thông tin đã match.
Nhờ text index không backtrack và fallback chain có tổng chi phí tuyến tính, preprocessing mất O(m), search mất O(n), tổng là O(n + m) với O(m) memory. Đây là công cụ mạnh cho deterministic substring search, repetitive/adversarial input, sequence matching và streaming—nhưng trong JavaScript thông thường, hãy benchmark với indexOf() native trước.
Hướng dẫn Recursion và Memoization bằng TypeScript: Top-Down DP, state, recurrence, cache key, độ phức tạp, stack overflow, async memoization và lỗi thường gặp.