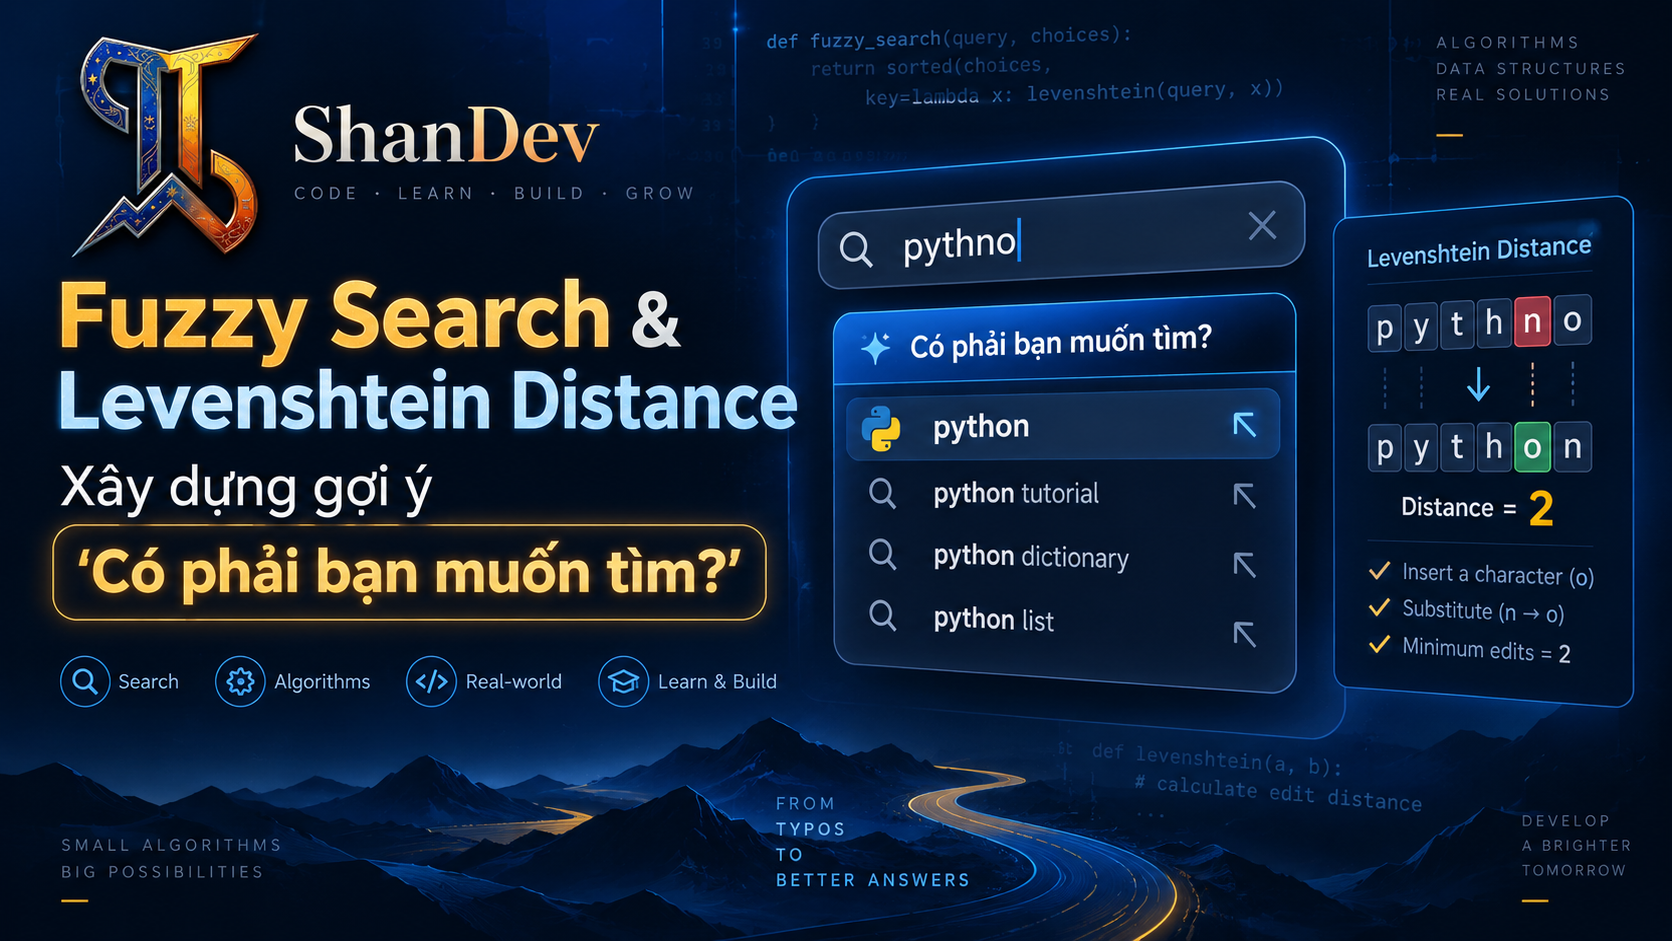
Hướng dẫn Fuzzy Search và Levenshtein Distance: công thức DP, TypeScript, Unicode, Damerau, ngưỡng gợi ý, candidate retrieval, ranking và PostgreSQL pg_trgm.
ShanverseUpdated 12 min read— viewsLoading views
String Algorithms
Algorithms
Từ exact search đến “Có phải bạn muốn tìm?”
Exact search thất bại khi user nhập:
Một hệ thống gợi ý cần trả lời hai câu hỏi:
Query và candidate khác nhau bao nhiêu?
Candidate nào có khả năng là ý định thật của user?
Levenshtein Distance giúp câu đầu. Câu thứ hai còn cần popularity, prefix, token overlap, lịch sử query, business rules và confidence threshold.
Mermaid
Loading diagram…
Levenshtein Distance là gì?
Cho hai chuỗi
Comments
source
và
target
, mỗi thao tác có cost 1:
Insert: thêm một ký tự.
Delete: xóa một ký tự.
Substitute: thay một ký tự bằng ký tự khác.
Khoảng cách là tổng cost nhỏ nhất.
Ví dụ kitten → sitting
Distance bằng 3.
Một nuance về đảo ký tự
Levenshtein chuẩn coi đây thường là hai thao tác, vì transposition không phải operation nguyên tử. Damerau–Levenshtein thêm phép đổi chỗ hai ký tự liền kề nên có thể cho distance 1.
Dynamic Programming State
Đặt:
Base cases:
Transition:
Mỗi cell chỉ cần ba trạng thái trước đó.
Vì sao recurrence đúng?
Một alignment tối ưu kết thúc bằng đúng một trong ba trường hợp:
Ký tự cuối của source bị xóa.
Ký tự cuối của target được chèn.
Hai ký tự cuối match hoặc substitute.
Nếu prefix trước bước cuối không tối ưu, ta có thể thay bằng prefix tốt hơn và làm toàn bộ solution tốt hơn—mâu thuẫn với giả định tối ưu. Đây là optimal substructure.
Ma trận ví dụ
Với cat và cut:
Kết quả 1: thay a bằng u.
TypeScript: bản tối ưu bộ nhớ
Full matrix cần O(mn) memory. Nếu chỉ cần distance, giữ hai row:
Complexity:
Nếu cần trả lại chuỗi thao tác cụ thể, thường phải giữ full matrix hoặc dùng kỹ thuật reconstruction phức tạp hơn.
Unicode: string.length không phải số ký tự user nhìn thấy
JavaScript dùng UTF-16 code units. Emoji, combining marks và một số ký tự có thể chiếm nhiều code units.
Array.from() tốt hơn code-unit iteration vì đi theo Unicode code points, nhưng vẫn có thể tách grapheme cluster như emoji gia đình hoặc chữ có combining mark.
Dùng Intl.Segmenter khi muốn so sánh user-perceived characters:
Normalization là product policy
Pipeline phổ biến:
Không tự động bỏ dấu tiếng Việt nếu dấu thay đổi nghĩa hoặc tạo quá nhiều false positive. Nếu product muốn accent-insensitive search, lưu một normalized search field riêng và vẫn giữ original text để hiển thị.
Distance không phải Similarity Probability
Có thể chuẩn hóa:
Nhưng 0.8 không có nghĩa 80% khả năng candidate đúng. Đây chỉ là feature cần calibration với dữ liệu thật.
Ngưỡng phải phụ thuộc độ dài
Distance 2 là lớn với query 3 ký tự nhưng nhỏ với query 20 ký tự.
Một policy minh họa:
Không copy ngưỡng này trực tiếp vào production. Đo precision, recall, suggestion acceptance và zero-result recovery theo language/domain.
Early Exit và Banded Dynamic Programming
Nếu chỉ quan tâm distance tối đa k:
Nếu abs(m - n) > k, reject ngay.
Chỉ tính các cell gần đường chéo |i - j| ≤ k.
Nếu minimum của row vượt k, có thể dừng sớm trong implementation phù hợp.
Điều này giảm công việc khi candidate rõ ràng không phù hợp. Các thuật toán threshold-aware như Ukkonen khai thác ý tưởng vùng band thay vì luôn tính toàn ma trận.
Fuzzy Search không nên scan toàn bộ database
Giả sử có N candidates, query dài m, candidate dài trung bình n:
Với hàng triệu rows, đây không phải kiến trúc search tốt.
Production nên có hai giai đoạn:
Candidate generation: tìm vài chục/hàng trăm item có vẻ gần.
Reranking: tính Levenshtein và signals chính xác trên tập nhỏ.
Các chiến lược Candidate Generation
1. Length Filter
Nếu threshold là k, candidate hợp lệ phải thỏa:
Cheap filter nhưng chưa đủ.
2. Prefix và Exact Index
Ưu tiên exact match, normalized exact match và prefix trước fuzzy. User thường không muốn một typo candidate vượt exact product name.
3. Trigram Index
Tách chuỗi thành các nhóm ba ký tự. Các chuỗi gần nhau thường chia sẻ nhiều trigrams.
Trigram index rất phù hợp để lấy candidates nhanh rồi rerank bằng edit distance.
PostgreSQL pg_trgm hỗ trợ similarity cùng GiST/GIN indexes:
Sau đó application có thể rerank top candidates bằng Levenshtein, popularity và availability.
4. BK-tree
BK-tree index các item theo metric distance. Khi query với radius k, triangle inequality giúp bỏ qua nhiều nhánh.
Phù hợp với:
Dictionary tương đối ổn định.
Distance threshold nhỏ.
Query theo whole token.
Có thể giảm hiệu quả với distribution xấu, threshold lớn hoặc dimension/length phức tạp.
5. Trie + DP Row
Khi duyệt trie, mỗi node cập nhật một DP row. Nếu toàn bộ row vượt threshold, prune subtree. Hữu ích cho autocomplete/dictionary search.
6. SymSpell-style Delete Index
Precompute delete variants để lookup typo nhanh. Đổi lại là memory/index build và logic cập nhật.
Ranking “Có phải bạn muốn tìm?”
Không sort chỉ theo distance. Một scoring model minh họa:
Các trọng số phải được học/tune từ dữ liệu. Có thể thêm:
Query frequency.
Click-through rate.
Conversion rate.
User locale.
Category context.
Inventory/availability.
Personalization có privacy controls.
Tie-breaking ổn định
Khi score bằng nhau:
Exact/prefix quality.
Lower edit distance.
Higher popularity.
Lexicographic hoặc stable ID.
Deterministic results giúp test và cache ổn định.
Một didYouMean đơn giản
Đây phù hợp với candidate set nhỏ đã được prefilter. Không truyền toàn bộ catalog vào function mỗi keystroke.
Whole Query hay từng Token?
Với query nhiều từ:
Whole-string distance có thể hữu ích nhưng dễ bị word order và extra token chi phối. Một pipeline tốt có thể:
Segment/tokenize theo locale.
Sửa từng token bằng vocabulary.
Tạo một số candidate query có giới hạn.
Search/rank documents bằng full-text/BM25/trigram.
Chỉ show suggestion khi confidence đủ cao.
Không dùng split(" ") cho mọi language. Intl.Segmenter hỗ trợ locale-sensitive word segmentation.
Chọn Metric đúng bài toán
Fuzzy spelling và semantic search là hai bài toán khác nhau. car và automobile gần nghĩa nhưng Levenshtein xa; javscript gần chữ với javascript nhưng semantic model không nhất thiết là giải pháp rẻ nhất.
Debounce, Cache và Resource Limits
Search-as-you-type cần:
Debounce khoảng thời gian phù hợp UX.
Cancel request cũ bằng AbortController.
Minimum query length.
Maximum Unicode/grapheme length.
Candidate count cap.
Per-user/IP rate limit.
Cache normalized popular queries.
Timeout và observability.
Không chạy O(Nmn) trên main thread cho catalog lớn. Browser có thể dùng Web Worker cho tập nhỏ; backend/search engine phù hợp hơn với dữ liệu lớn.
Đo chất lượng
Offline evaluation:
Dataset (misspelled query, intended query).
Precision@1, Recall@k, MRR.
Breakdown theo length, locale, device và typo type.
Online metrics:
Suggestion click/accept rate.
Zero-result recovery.
Reformulation rate.
Search success/conversion.
Latency P50/P95/P99.
False correction complaints.
Không auto-correct âm thầm khi confidence thấp. “Did you mean?” cho user quyền kiểm soát và dễ đo hơn.
Privacy và Abuse
Query logs có thể chứa email, số điện thoại, health terms hoặc secret user dán nhầm. Cần:
Data minimization.
Redaction phù hợp.
Retention policy.
Access control.
Không log raw query nếu không cần.
Chống suggestion poisoning bằng bot queries/clicks.
Popularity signal không được phép biến spam thành gợi ý hàng đầu.
Những lỗi thường gặp
So sánh query với mọi row.
Dùng raw UTF-16 code units như “ký tự”.
Bỏ qua Unicode normalization.
Strip dấu cho mọi ngôn ngữ mà không đánh giá false positives.
Dùng threshold cố định cho mọi độ dài.
Xem normalized similarity là probability.
Chỉ rank theo edit distance.
Auto-correct query ngắn như go, c, ai quá mạnh.
Không phân biệt typo với semantic synonym.
Dùng Levenshtein cho document dài.
Không cap query length/candidate count.
Chạy thuật toán đồng bộ nặng trên UI thread.
Không test transposition và multibyte text.
Testing checklist
Empty với empty bằng 0.
Empty với chuỗi dài n bằng n.
Symmetry với cost đồng nhất.
kitten → sitting bằng 3.
Equal strings bằng 0.
Insert/delete/substitute cases.
Transposition khác Levenshtein và Damerau.
NFC/NFD versions theo policy cho kết quả nhất quán.
Emoji và grapheme clusters không bị cắt sai.
Vietnamese case/diacritics theo policy.
Query ngắn không bị over-correct.
Length filter không loại candidate hợp lệ.
Threshold boundary k-1, k, k+1.
Tie-breaking deterministic.
Candidate cap và timeout.
SQL index được dùng qua EXPLAIN.
Logs không chứa dữ liệu nhạy cảm ngoài policy.
Production checklist
Xác định typo, name matching hay semantic search.
Normalization/tokenization theo locale.
Exact/prefix match trước fuzzy.
Indexed candidate retrieval.
Levenshtein chỉ rerank tập nhỏ.
Length-aware threshold.
Popularity/context signals có chống abuse.
Unicode/grapheme policy rõ ràng.
Debounce, cancellation và rate limiting.
Query/candidate size limits.
Offline relevance dataset.
Online quality và latency metrics.
A/B test trước khi auto-correct.
Privacy/retention policy cho query logs.
Kết luận
Levenshtein Distance biến cảm giác “hai chuỗi gần nhau” thành một bài toán Dynamic Programming chính xác với O(mn) time. Bản two-row giảm memory xuống O(min(m,n)); threshold, banding và early exit giúp tối ưu thêm.
Nhưng tính distance không tự tạo ra tính năng “Có phải bạn muốn tìm?”. Production cần pipeline gồm locale-aware normalization, indexed candidate generation, edit-distance reranking, popularity/context signals, confidence threshold và đo chất lượng. Với catalog lớn, trigram/BK-tree/Trie/SymSpell tìm ứng viên; Levenshtein làm bước đánh giá chính xác cuối cùng.
Hướng dẫn Recursion và Memoization bằng TypeScript: Top-Down DP, state, recurrence, cache key, độ phức tạp, stack overflow, async memoization và lỗi thường gặp.