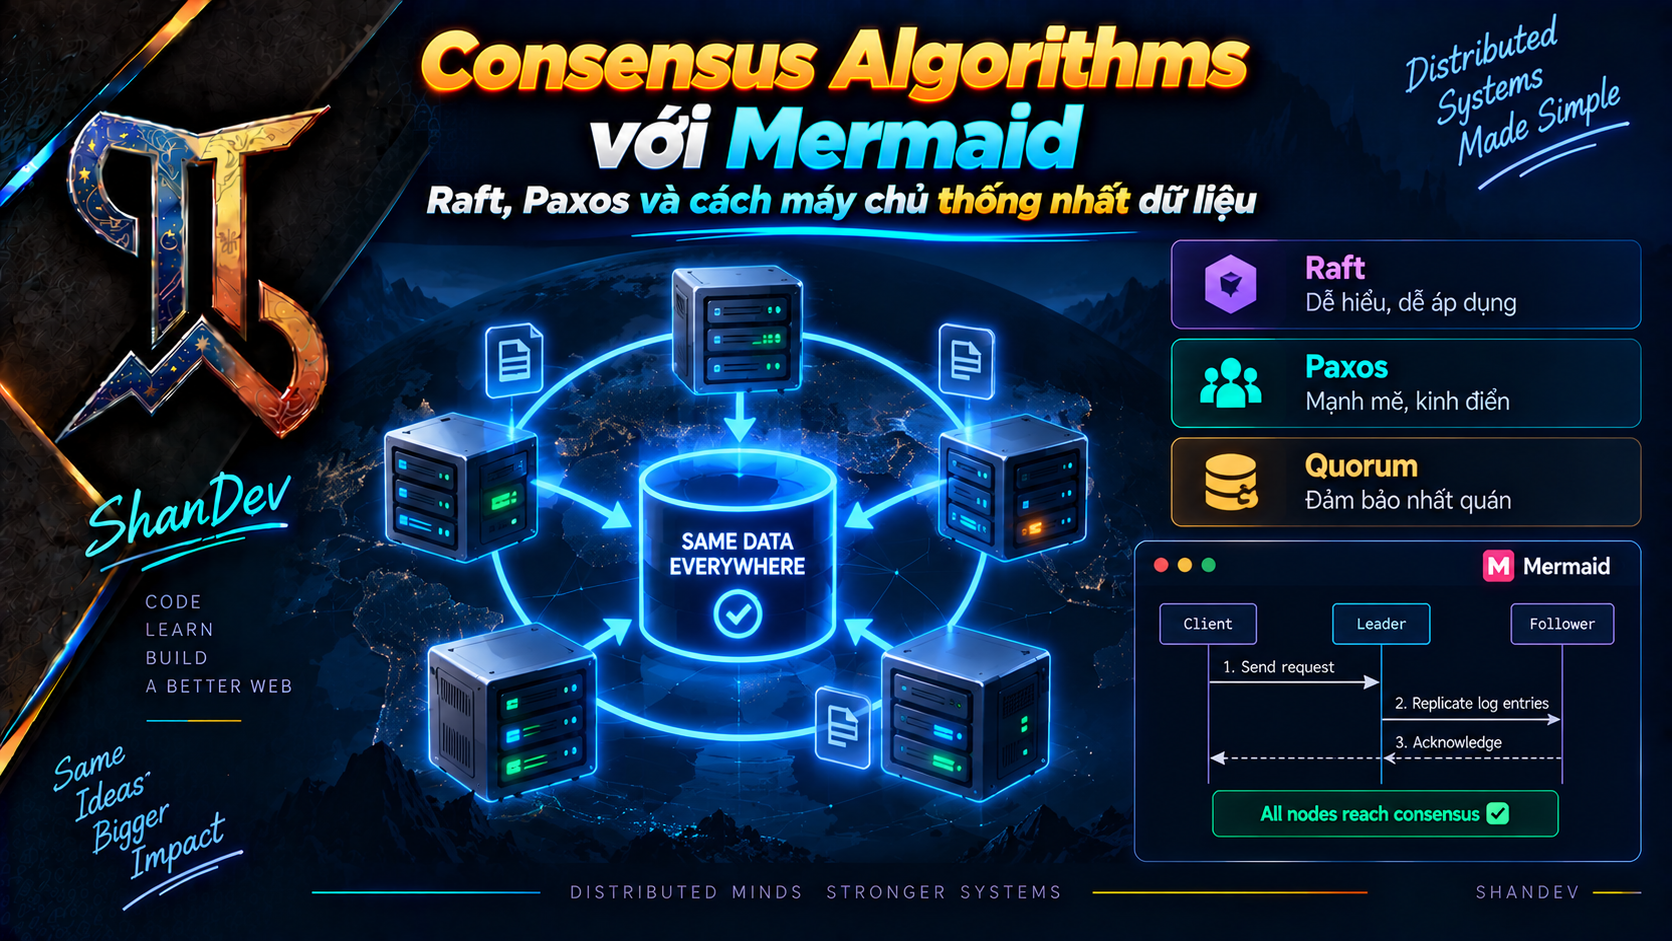
Consensus Algorithms với Mermaid: Raft, Paxos và cách máy chủ thống nhất dữ liệu
Tìm hiểu Consensus Algorithms qua sơ đồ Mermaid: cách Raft và Paxos dùng majority quorum, leader election và replicated log để đảm bảo dữ liệu nhất quán.
ShanverseUpdated 12 min read— viewsLoading views
Distributed Systems
Algorithms
Bài toán: 5 máy chủ nhưng dữ liệu nào là đúng?
Giả sử một hệ thống có 5 node. Client gửi lệnh:
Ngay lúc đó:
Leader có thể crash.
Message tới một số follower bị trễ.
Một follower đã ghi log nhưng chưa apply.
Client timeout và gửi lại request.
Network partition chia cluster thành nhóm 3 và nhóm 2.
Nếu mỗi node tự quyết định, hệ thống có thể xuất hiện hai lịch sử khác nhau. Consensus giải bài toán: các node không hỏng phải thống nhất một giá trị hoặc một thứ tự lệnh duy nhất.
Mermaid
Loading diagram…
Đây là mô hình
Comments
Replicated State Machine
:
Consensus thống nhất thứ tự log.
Mỗi node apply cùng lệnh theo cùng thứ tự.
State machine deterministic tạo ra cùng trạng thái.
Nếu command dùng random, thời gian local hoặc external API khác nhau, kết quả có thể lệch dù log giống nhau. Vì thế command phải deterministic hoặc mọi input không xác định phải được ghi vào log.
Consensus phải đảm bảo điều gì?
Safety
“Điều xấu không bao giờ xảy ra.”
Không có hai giá trị khác nhau cùng được quyết định cho một slot.
Một log entry đã commit không bị thay bằng entry mâu thuẫn.
Node không apply một giá trị chưa thực sự được chọn.
Safety phải giữ ngay cả khi network partition. Thuật toán an toàn có thể tạm ngừng ghi thay vì tạo hai sự thật.
Liveness
“Cuối cùng hệ thống vẫn tiến lên.”
Khi mạng ổn định đủ lâu và đủ node hoạt động, một leader được bầu và request mới được commit.
Trong mạng hoàn toàn bất đồng bộ, không thể luôn phân biệt “node đã chết” với “node chỉ chậm”. Timeout giúp hệ thống thực tế tiến lên, nhưng timeout không phải bằng chứng node đã chết.
Quorum: phép toán nền tảng
Với N voter:
Hai majority quorum luôn giao nhau ít nhất một node. Phần giao nhau giúp thông tin về quyết định cũ đi vào quyết định mới.
Mermaid
Loading diagram…
Cluster thường dùng 3 hoặc 5 voter. Thêm node chẵn không nhất thiết tăng khả năng chịu lỗi: 3 và 4 đều chỉ chịu được 1 lỗi, nhưng quorum của 4 là 3.
Network partition: ai được quyền ghi?
Mermaid
Loading diagram…
Nhóm 3 có majority nên có thể bầu leader và commit. Nhóm 2 không có quorum nên phải từ chối hoặc treo write.
Đây là lý do consensus tránh split brain: không phải vì minority “biết chắc” nó sai, mà vì minority không thể thu đủ phiếu để tạo quyết định mới.
Raft: chia consensus thành các phần dễ hiểu
Raft tổ chức node theo ba trạng thái:
Follower: nhận heartbeat và log từ leader.
Candidate: khởi động election khi timeout.
Leader: nhận write, replicate log, điều phối commit.
Thời gian được chia thành các term tăng dần. Mỗi term có tối đa một leader hợp lệ.
Mermaid
Loading diagram…
Raft leader election
Follower không nhận heartbeat trong election timeout ngẫu nhiên sẽ:
Tăng term.
Chuyển thành Candidate.
Vote cho chính mình.
Gửi RequestVote.
Trở thành Leader nếu nhận majority.
Mermaid
Loading diagram…
Vì sao timeout phải random?
Nếu mọi node timeout cùng lúc, chúng cùng thành candidate và chia phiếu. Randomized timeout giảm khả năng election lặp lại đồng thời.
Ai được nhận vote?
Raft không chỉ so term. Candidate phải có log ít nhất “up-to-date” như voter. Quy tắc này ngăn node thiếu committed entries trở thành leader rồi làm mất lịch sử đã commit.
Mỗi node vote tối đa một lần trong một term và phải persist term/vote trước khi phản hồi.
Raft log replication
Client thường gửi write đến leader:
Mermaid
Loading diagram…
Một flow thực tế:
Leader append command vào durable log.
Leader gửi AppendEntries tới followers.
Khi điều kiện majority và safety được thỏa, entry được commit.
Node apply committed entry vào state machine theo thứ tự.
Leader phản hồi client.
Raft có quy tắc commit tinh tế: leader không chỉ đếm majority một cách mù quáng cho entry từ term cũ; nó dùng quy tắc current-term để bảo toàn Leader Completeness. Không nên tự hiện thực Raft chỉ từ sơ đồ đơn giản.
Log matching và sửa follower bị lệch
Mỗi entry có index và term. AppendEntries mang thông tin về entry liền trước.
Nếu follower không khớp:
Follower từ chối append.
Leader lùi điểm đồng bộ.
Leader tìm prefix chung.
Phần log mâu thuẫn chưa commit trên follower bị thay bằng log leader.
Mermaid
Loading diagram…
Entry đã commit không được phép biến mất. Entry chỉ mới tồn tại trên một minority có thể bị rollback sau leader change.
Tình huống khó: đã commit nhưng client timeout
Leader có thể:
Commit request vào majority.
Crash trước khi trả response.
Client timeout và retry sang leader mới.
Consensus bảo vệ log, nhưng không tự động ngăn business operation chạy hai lần. Client cần requestId/idempotency key và state machine cần ghi nhớ kết quả đã xử lý.
Idempotency record phải là một phần của replicated state, không chỉ nằm trong memory của leader.
Read không đơn giản như tưởng tượng
Follower read có thể stale. Leader vừa bị partition cũng có thể chưa biết mình đã mất quorum.
Để đạt linearizable read, hệ thống thường dùng một trong các cơ chế:
Ghi một entry/no-op qua quorum.
ReadIndex hoặc quorum confirmation.
Leader lease với giả định timing/clock được định nghĩa cẩn thận.
Không nên mặc định “đọc từ leader luôn linearizable” nếu implementation chưa chứng minh leader vẫn có authority.
Paxos: thống nhất một giá trị bằng ballot
Basic Paxos có các vai trò logic:
Proposer: đề xuất giá trị.
Acceptor: hứa và chấp nhận ballot/value.
Learner: học giá trị đã được chọn.
Một node vật lý có thể giữ nhiều vai trò.
Phase 1 — Prepare / Promise
Proposer chọn ballot number duy nhất và gửi Prepare(n).
Acceptor trả Promise nếu n lớn hơn mọi ballot nó đã hứa trước đó. Nó cũng trả accepted proposal có ballot cao nhất nếu đã từng accept.
Phase 2 — Accept / Accepted
Sau majority Promise:
Nếu chưa accept giá trị nào, proposer có thể dùng giá trị của mình.
Nếu có accepted value, proposer phải chọn giá trị có ballot cao nhất nhận được.
Proposer gửi Accept(n, value).
Giá trị được chọn khi majority accept.
Mermaid
Loading diagram…
Tại sao Paxos không chọn nhầm hai giá trị?
Hai majority quorum luôn overlap. Trong Phase 1, proposer mới phải hỏi majority về lịch sử accepted. Nếu một giá trị đã được chọn, ít nhất một acceptor trong quorum mới biết nó. Quy tắc chọn accepted value có ballot cao nhất truyền ràng buộc an toàn sang ballot sau.
Ballot number lớn hơn không tự động “ghi đè dữ liệu”. Nó cho proposer quyền tiến hành, nhưng proposer vẫn phải tôn trọng giá trị đã có thể được chọn.
Multi-Paxos
Basic Paxos chọn một giá trị. Replicated log cần chọn liên tục cho nhiều slot.
Multi-Paxos dùng một leader ổn định để:
Chạy Phase 1 khi giành leadership.
Sau đó thường đi thẳng Phase 2 cho nhiều log slots.
Chạy prepare lại khi leader/ballot thay đổi.
Vì vậy, so sánh production thường là Raft với Multi-Paxos, không phải một vòng Basic Paxos đơn lẻ.
Raft và Paxos giống và khác gì?
Cả hai có thể đạt safety tương đương trong mô hình crash-fault phù hợp. Raft không “mạnh hơn” Paxos; nó được thiết kế để dễ hiểu và dễ xây dựng hệ thống hơn.
Điều consensus không giải quyết
Không chống Byzantine fault
Raft/Paxos cổ điển giả định node có thể crash, restart hoặc mất kết nối nhưng không cố ý gửi thông tin mâu thuẫn cho các peer.
Nếu node có thể gian lận hoặc bị compromise, cần Byzantine Fault Tolerance. Mô hình BFT cổ điển thường cần ít nhất 3f + 1 replica để chịu f Byzantine faults, cùng các giả định bổ sung.
Không thay backup
Nếu lỗi operator xóa dữ liệu và lệnh xóa được consensus commit, mọi replica sẽ nhất quán… cùng mất dữ liệu. Vẫn cần backup, PITR và kiểm thử restore.
Không biến slow disk thành fast system
Write latency thường bị giới hạn bởi stable storage và quorum path. Node chậm có thể gây election hoặc tăng tail latency.
Không tự đảm bảo exactly-once
Timeout tạo trạng thái “không biết đã commit hay chưa”. Exactly-once ở cấp business cần idempotency và transaction semantics.
CAP: consensus chọn gì khi partition?
Một majority-based consensus cluster thường ưu tiên Consistency trong partition:
Majority partition tiếp tục xử lý nếu đủ điều kiện.
Minority partition từ chối write.
Nếu không partition nào có majority, write unavailable.
Điều này không có nghĩa hệ thống “CP trong mọi API”. Follower/stale reads, cache và async replication có thể mang semantics khác. Hãy mô tả consistency theo từng operation.
Membership changes
Không được thay cluster từ {A,B,C} sang {C,D,E} bằng một bước ngây thơ. Hai cấu hình có thể tạo hai majority không giao nhau.
Raft joint consensus dùng giai đoạn chuyển tiếp với old + new configuration và yêu cầu quorum theo quy tắc của cả hai cấu hình.
Mermaid
Loading diagram…
Reconfiguration là một protocol, không chỉ là sửa danh sách IP.
Snapshot, log compaction và recovery
Replicated log không thể tăng mãi. Hệ thống cần:
Snapshot state machine tại committed index.
Compact prefix log đã nằm trong snapshot.
Cài snapshot cho follower quá chậm.
Giữ metadata term/index cần thiết.
Verify checksum và crash recovery.
Snapshot không thay backup; snapshot lỗi logic vẫn có thể được replicate.
Production checklist
Chọn thư viện/hệ thống consensus đã được kiểm chứng thay vì tự viết.
Dùng 3 hoặc 5 voter theo failure budget và latency.
Trải node qua failure domain độc lập.
Dùng stable storage và hiểu chính sách fsync.
Election timeout lớn hơn đáng kể heartbeat/network/disk jitter.
Không đặt voter qua WAN tùy tiện mà chưa đo quorum latency.
Theo dõi term, leader changes, commit/applied index và replication lag.
Cảnh báo khi mất quorum hoặc còn đúng một failure margin.
Dùng idempotency key cho client retry.
Xác định rõ read consistency: stale, sequential hay linearizable.
Thay membership qua protocol được hỗ trợ.
Snapshot/compaction không làm mất khả năng recovery.
Backup và restore drill độc lập với replication.
Test kill -9, disk full, fsync chậm, packet loss, partition và clock jump.
Drain leader/voter an toàn trước maintenance.
Anti-patterns
Chạy 2 voter và kỳ vọng chịu được 1 node lỗi.
Coi timeout là bằng chứng node đã chết.
Cho minority tiếp tục ghi “để tăng availability”.
Ack client trước khi đạt durability/commit contract.
Đọc từ follower rồi gọi đó là strong consistency.
Retry mutation không có request ID.
Thay voter list thủ công đồng thời trên từng node.
Đặt tất cả voter trong cùng rack/zone.
Coi replication là backup.
Tự triển khai Raft/Paxos từ một bài blog và đưa thẳng vào production.
Kết luận
Consensus hoạt động nhờ ba ý chính:
Quorum intersection giữ lịch sử quyết định không bị đứt.
Monotonic epochs — term trong Raft, ballot trong Paxos — sắp xếp authority.
Durable replicated state truyền quyết định qua crash và leader change.
Raft diễn đạt bài toán bằng leader election, log replication và safety rules. Paxos diễn đạt bằng Prepare/Promise, Accept và quorum intersection. Khi mạng bị chia cắt, phần không có majority phải dừng write để không sinh ra hai sự thật.
Giải thích kiến trúc Event Sourcing và CQRS trong core banking, từ immutable ledger, double-entry, balance projection, idempotency đến replay, reconciliation và eventual consistency.