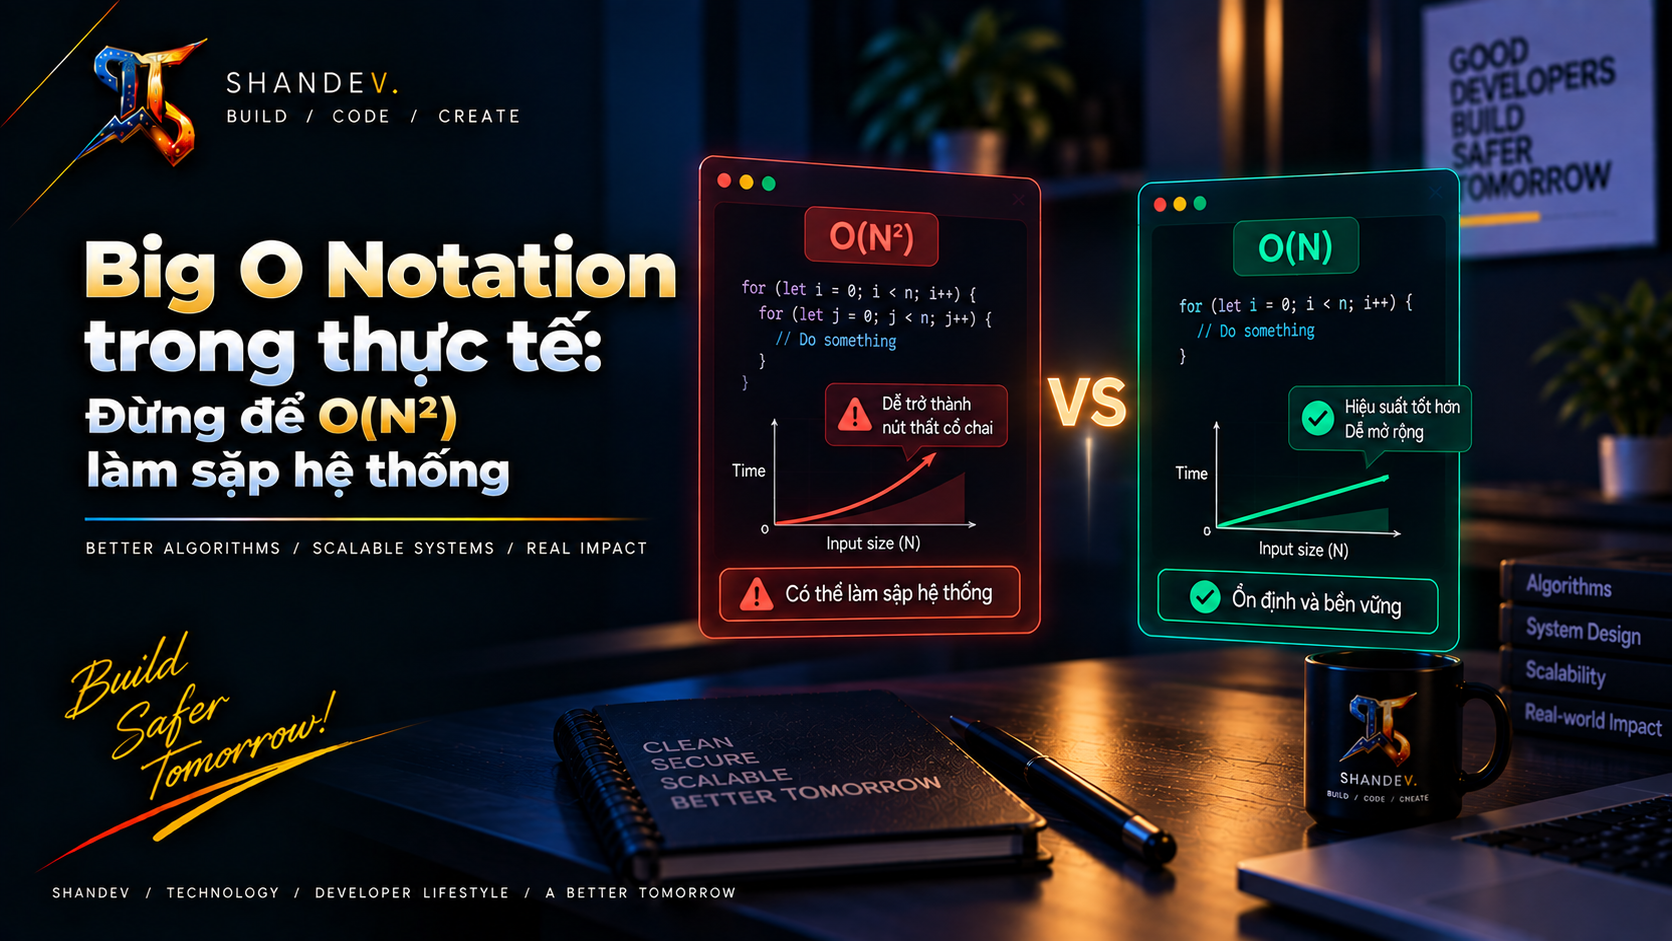
Big O Notation trong thực tế: Đừng để O(N²) làm sập hệ thống
Hướng dẫn Big O thực tế với TypeScript: O(1), O(log N), O(N), O(N log N), O(N²), ví dụ production, Set/Map, database, N+1 query và load testing.
ShanverseCập nhật 11 phút đọc— lượt xemĐang tải lượt xem
Big O
Algorithms
Big O giải quyết câu hỏi nào?
Big O mô tả tốc độ tăng của tài nguyên khi kích thước input tăng:
Thời gian CPU.
Bộ nhớ.
Số lần đọc/ghi database.
Số network round trips.
Số object allocations hoặc lượng dữ liệu truyền.
Nếu T(N) = 3N² + 20N + 500, khi N đủ lớn thì N² chi phối. Ta nói T(N) = O(N²) để tập trung vào growth rate, không phải vì constants biến mất ngoài đời.
Bình luận
Big O không phải đồng hồ bấm giờ
Big O không cho biết:
Một operation mất bao nhiêu nanoseconds.
Cache hit hay disk I/O.
JIT, garbage collection, branch prediction.
Query chạy local hay qua network.
Payload rộng bao nhiêu bytes.
p99 latency khi hệ thống tranh chấp tài nguyên.
Hai implementations cùng O(N) có thể chênh lệch 100 lần. Ngược lại, O(N²) có thể đủ nhanh nếu N ≤ 20 và được giới hạn cứng.
O, Ω và Θ
O(g(N)): asymptotic upper bound.
Ω(g(N)): asymptotic lower bound.
Θ(g(N)): tight bound, vừa trên vừa dưới cùng bậc.
Big O tự nó không đồng nghĩa với “worst case”. Ta có thể mô tả best, average, expected hoặc worst-case bằng Big O; phải nói rõ đang phân tích trường hợp nào.
Ví dụ Quicksort thường có expected/average O(N log N) nhưng worst-case O(N²) nếu pivot strategy và input bất lợi.
Bảng tăng trưởng trực giác
Tăng N từ 1.000 lên 100.000 là 100 lần:
O(N) tăng khoảng 100 lần.
O(N log N) tăng khoảng 166 lần.
O(N²) tăng 10.000 lần.
Nếu một inner operation là database query 5 ms, một nested loop không còn là bài toán CPU đơn giản—nó có thể tạo hàng nghìn giây I/O và làm cạn connection pool.
Cách phân tích code
Một loop: thường O(N)
Time O(N), extra space O(1).
Hai loop nối tiếp: O(N + M), không phải O(NM)
Nếu N và M cùng scale tương tự, có thể đơn giản thành O(N), nhưng giữ nhiều biến thường chính xác hơn.
Nested loops: chưa chắc O(N²)
Nếu mỗi item chỉ thuộc một group, tổng iterations là tổng số items: O(G + I), không phải O(G × I).
Nested loops trở thành cross product khi mỗi phần tử bên ngoài duyệt toàn bộ collection bên trong.
Case Study 1: Tìm phần tử trùng lặp
Phiên bản O(N²)
Worst-case comparisons gần N(N - 1) / 2.
Dùng Set: expected O(N)
Trade-off:
Tối ưu time thường trả bằng memory. Nếu input không fit RAM, cần sorting, external processing, database uniqueness constraint hoặc streaming design.
Case Study 2: includes() bên trong loop
Nếu có P products và S selected IDs, time là O(P × S) vì array membership là linear.
Build Set mất expected O(S), filter mất expected O(P):
Đây là một trong những hidden quadratic patterns phổ biến nhất trong JavaScript.
Case Study 3: N+1 Database Queries
Số query là 1 + N. Big O là O(N) round trips, nhưng constant là network/database latency và loop còn chạy tuần tự. Với 10.000 orders, hệ thống có thể “sập” trước khi CPU bận.
Batch IDs:
Application work gần O(N + C) và round trips gần constant, nhưng production vẫn cần:
Giới hạn batch size.
Index trên join/filter columns.
Pagination.
Chọn đúng fields để tránh payload lớn.
Quan sát query plan và rows scanned.
Promise.all() không làm số query biến mất. Nó chỉ chuyển sequential latency thành concurrency và có thể làm cạn connection pool nhanh hơn.
Case Study 4: Join bằng nested loop
Complexity là O(O × C).
Complexity expected O(O + C) và space O(C).
Case Study 5: Sort trong loop
Nếu sort cùng array T lần, cost khoảng O(T × N log N). Nếu thứ tự không đổi, sort một lần bên ngoài. Nếu liên tục lấy min/max và cập nhật, cân nhắc heap/priority queue với O(log N) mỗi operation.
Đừng thay data structure chỉ vì bảng Big O. Array thường nhanh và đơn giản với input nhỏ; benchmark workload thật.
Chọn đúng kích thước input
N không phải lúc nào cũng là “số rows”. Một endpoint có thể phụ thuộc vào:
Ví dụ:
Viết nhiều biến giúp lộ ra cross product và fan-out mà ký hiệu O(N) đơn giản che mất.
Worst, Average, Expected và Amortized
Worst case: upper bound cho input bất lợi nhất.
Average case: cần giả định phân phối input.
Expected: thường có randomness trong algorithm/data structure.
Amortized: trung bình trên cả chuỗi operations, không cần giả định input ngẫu nhiên.
Ví dụ dynamic array push thường O(1), đôi lúc resize mất O(N), nhưng amortized cost là O(1) trên một chuỗi pushes.
Amortized tốt không tự động bảo đảm p99 tốt. Một resize, rehash hoặc GC pause vẫn có thể chạm request cụ thể.
Database Complexity không chỉ là Big O
Một B-tree lookup thường được mô tả O(log N), nhưng latency còn phụ thuộc:
Index có được dùng không.
Selectivity.
Cache hit ratio.
Random I/O và page reads.
Lock contention.
Sort/hash spill ra disk.
Số rows và bytes trả về.
Network round trips.
Một query “có index” vẫn có thể chậm nếu trả 500.000 rows. Hãy xem EXPLAIN, rows scanned versus returned, buffer/cache metrics và query latency distribution.
Memory Complexity cũng có thể làm hệ thống sập
Cùng lúc có thể giữ:
ORM objects.
Mảng mới.
Serialized string/buffer.
Temporary allocations.
Dù time chỉ O(N), peak memory cũng O(N) với constant lớn. Nhiều requests đồng thời biến thành O(concurrency × N) memory và dẫn tới GC pressure hoặc out-of-memory.
Giải pháp: pagination, streaming, backpressure, projection, batch processing và giới hạn response size.
Ước lượng điểm gãy trước khi benchmark
Dùng back-of-the-envelope estimation:
Ví dụ N = 50.000:
Ngay cả giả định quá lạc quan 10 ns/comparison cũng là 25 giây CPU. Nếu inner operation là 100 µs, kết quả thành nhiều ngày.
Ước lượng không thay benchmark; nó giúp loại bỏ design không thể scale trước khi tốn công triển khai.
Benchmark đúng cách
Benchmark nhiều scales, không chỉ một N:
Nếu N tăng 10 lần:
Linear thường tăng gần 10 lần.
Quadratic có xu hướng tăng gần 100 lần.
Microbenchmark phải xử lý warm-up, JIT, dead-code elimination, GC, data distribution và noise. Với quyết định quan trọng, dùng benchmark harness đáng tin cậy và báo cáo distribution thay vì một lần đo.
Load Test mới kiểm tra được hệ thống
Microbenchmark không mô phỏng:
Connection pools.
Queues và backpressure.
Cache miss.
Database contention.
Network timeout/retry.
Nhiều tenants và noisy neighbors.
Memory pressure và GC.
Load test nên đo:
Throughput/RPS.
p50, p95, p99 latency.
Error và timeout rate.
CPU, memory, allocation, GC.
DB connections, query latency, rows scanned.
Queue depth và saturation.
Capacity planning phải bao gồm tăng trưởng tự nhiên, launch/marketing spikes và load testing định kỳ để liên hệ raw resources với service capacity.
Guardrails để O(N²) không lên production
Code Review
Input tối đa là bao nhiêu hôm nay và sau 12 tháng?
Loop bên trong có scan array, query DB hoặc gọi API không?
Có cross product không?
Có thể dùng Set, Map, index, batching hoặc precomputation không?
Trade-off memory là gì?
Runtime Limits
Pagination bắt buộc.
Max batch size.
Request body/response size limit.
Timeout và cancellation.
Concurrency limit.
Queue bounded và backpressure.
Circuit breaker cho dependencies.
CI và Observability
Benchmark nhiều input sizes.
Regression threshold cho hot path.
Slow-query log và APM traces.
Metrics theo cardinality/input size.
Alert theo p95/p99, saturation và error budget.
Khi nào O(N²) vẫn chấp nhận được?
N có hard cap nhỏ, ví dụ tối đa 20 permissions.
Code chạy offline/batch với deadline phù hợp.
Algorithm chính xác yêu cầu pairwise comparison và chưa có cấu trúc tốt hơn.
N² phase áp dụng sau bước candidate reduction rất mạnh.
Simplicity đáng giá hơn optimization và benchmark chứng minh có headroom.
Ghi hard cap vào validation, không chỉ comment. Nếu giới hạn business thay đổi, alert/benchmark phải phát hiện regression.
Quy trình tối ưu thực tế
Định nghĩa input size: rows, edges, bytes, queries, tenants.
Viết cost model: CPU, memory, I/O, round trips.
Tìm term chi phối:N², N×M, sort lặp, fan-out.
Ước lượng điểm gãy: current, 10× và 100× data.
Đổi thuật toán/data structure: Set, Map, index, heap, batching.
Giới hạn công việc: pagination, cap, timeout, backpressure.
Benchmark nhiều scales: kiểm tra đường cong, không chỉ một số.
Load test end-to-end: đo tail latency và saturation.
Deploy có guardrail: canary, metrics, rollback.
Theo dõi growth: capacity planning là quá trình liên tục.
Checklist Production
Biết N là gì và upper bound thực tế.
Phân tích cả time, space, I/O và round trips.
Phân biệt worst, expected và amortized behavior.
Không có includes/find/filter linear trong hot loop nếu input lớn.
Không có N+1 query/API calls.
Index/filter/join columns phù hợp.
Pagination và max batch size được enforce.
Concurrency có giới hạn; không dùng Promise.all vô hạn.
Response và intermediate allocations được kiểm soát.
Benchmark ở nhiều input sizes với dữ liệu đại diện.
Load test đo p95/p99 và saturation.
Slow paths có tracing và metrics theo input size.
Capacity forecast bao gồm organic và launch spikes.
Có fallback, timeout, cancellation và rollback plan.
Kết luận
Big O không thay profiler, benchmark hay load test. Nó là radar sớm: giúp thấy một implementation sẽ phản ứng thế nào khi data tăng trước khi constants, database và traffic biến vấn đề thành incident.
Mục tiêu không phải xóa mọi O(N²). Mục tiêu là biết N, biết upper bound, biết điểm gãy và đặt guardrails. Khi growth rate nguy hiểm trên hot path, hãy giảm work bằng data structure tốt hơn, indexing, batching, candidate reduction, pagination và backpressure—sau đó xác minh bằng measurement thực tế.
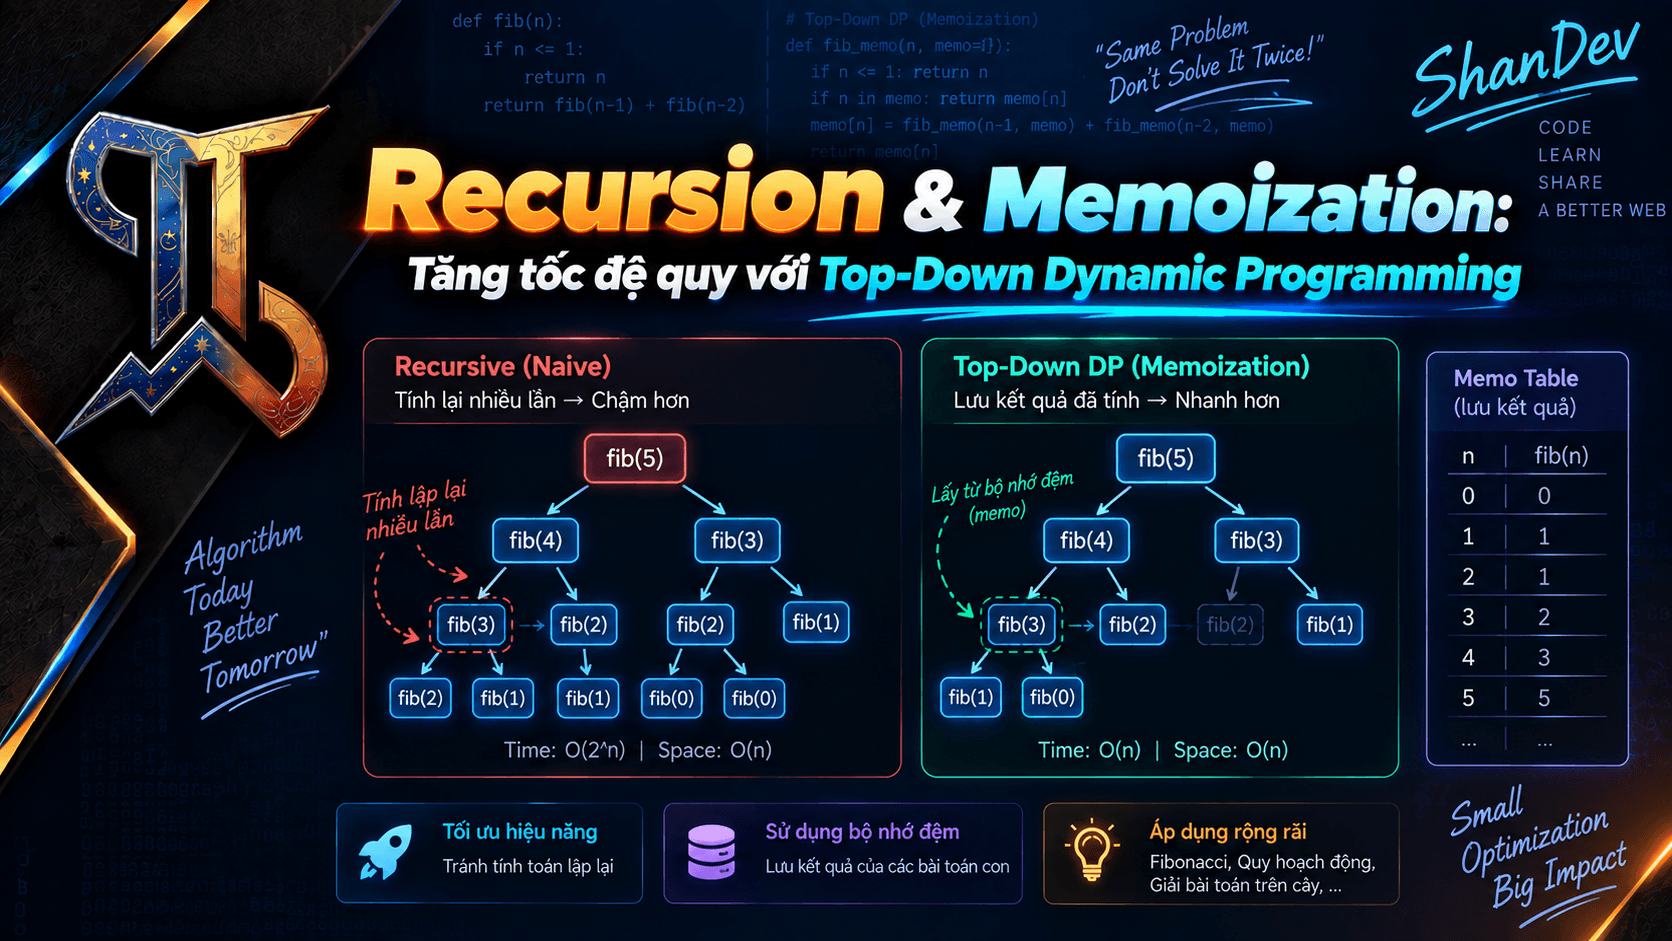
Hướng dẫn Recursion và Memoization bằng TypeScript: Top-Down DP, state, recurrence, cache key, độ phức tạp, stack overflow, async memoization và lỗi thường gặp.