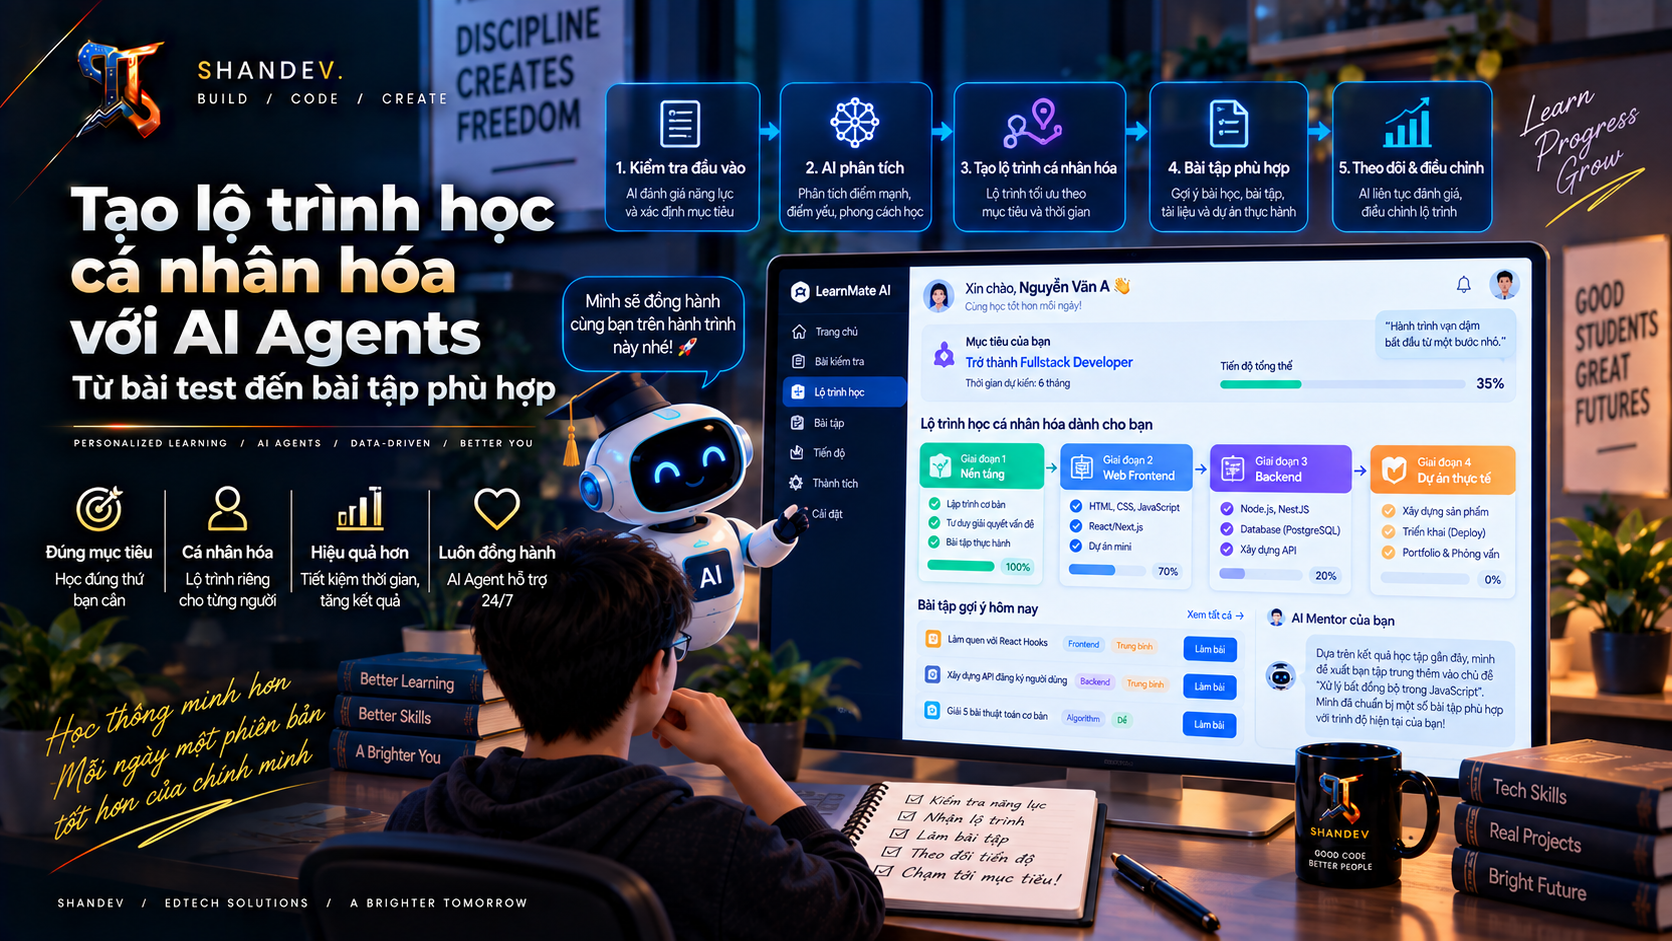
Tạo lộ trình học cá nhân hóa với AI Agents: Từ bài test đến bài tập phù hợp
Hướng dẫn xây hệ thống học tập cá nhân hóa bằng AI Agents, Knowledge Tracing, ngân hàng câu hỏi và LLM để phát hiện điểm yếu, tạo bài luyện tập phù hợp và bảo vệ dữ liệu học sinh.
ShanverseUpdated 11 min read— viewsLoading views
AI Agents
EdTech
Bài toán cần giải quyết
Sau mỗi bài test, hệ thống phải trả lời bốn câu hỏi:
Học sinh đã thành thạo những kiến thức/kỹ năng nào?
Sai vì chưa hiểu, nhầm lẫn nhất thời hay câu hỏi có vấn đề?
Nên học gì tiếp theo, theo thứ tự nào và với khối lượng bao nhiêu?
Bài tập/tài liệu sinh ra có đúng chương trình, đúng mức độ và an toàn không?
Điểm tổng 6/10 là chưa đủ. Hai học sinh cùng điểm có thể có lỗ hổng hoàn toàn khác nhau: một người yếu phân số, người kia sai vì đọc đề hoặc tính toán bất cẩn. Vì vậy, đơn vị cốt lõi phải là knowledge component — một kỹ năng đủ nhỏ để quan sát và luyện tập.
Nguyên tắc thiết kế
AI đề xuất; giáo viên và người học có quyền xem, sửa hoặc từ chối.
Comments
Không dùng hệ thống cho quyết định kỷ luật, xếp hạng hoặc đánh giá có hệ quả cao nếu chưa được thẩm định độc lập.
Tách mô hình đo lường khỏi LLM tạo nội dung.
Không biến một câu trả lời sai thành kết luận chắc chắn về năng lực.
Lưu bằng chứng, độ tin cậy và lý do cho mỗi đề xuất.
Thu thập tối thiểu dữ liệu cần thiết; không suy luận đặc điểm nhạy cảm.
Kiến trúc tổng thể
Mermaid
Loading diagram…
Các thành phần chính:
Skill graph: kỹ năng, prerequisite và chuẩn đầu ra.
Item bank: câu hỏi đã gắn kỹ năng, độ khó, đáp án, rubric và lịch sử chất lượng.
Student model: xác suất thành thạo theo từng kỹ năng.
Diagnostic Agent: giải thích lỗi dựa trên evidence.
Planner Agent: chọn mục tiêu, thứ tự và thời lượng.
Generator Agent: tạo biến thể bài tập và lời giải.
Verifier Agent: kiểm tra đáp án, độ khó, coverage, safety và duplication.
Teacher dashboard: duyệt, chỉnh sửa, override và theo dõi tiến bộ.
Bước 1: Xây skill graph trước
Ví dụ môn Toán:
Mỗi skill nên có:
Mã ổn định, tên và mô tả quan sát được.
Prerequisite và kỹ năng kế tiếp.
Lớp/khung chương trình áp dụng.
Ví dụ đúng, misconception phổ biến.
Tiêu chí mastery và nguồn nội dung được duyệt.
Đừng để LLM tự phát minh skill graph cho production. Giáo viên/chuyên gia môn học phải quản trị taxonomy và version của chương trình.
Bước 2: Chuẩn hóa dữ liệu bài test
Dùng event ID để xử lý idempotent. Version item/rubric giúp tái hiện vì sao hệ thống chấm và đề xuất như vậy tại một thời điểm.
Bước 3: Ước lượng điểm yếu bằng Knowledge Tracing
Với MVP, bắt đầu bằng luật minh bạch hoặc Bayesian Knowledge Tracing (BKT), thay vì deep model khó giải thích. BKT theo dõi xác suất học sinh đã thành thạo một kỹ năng dựa trên:
Xác suất biết trước.
Xác suất học được sau một cơ hội luyện tập.
Xác suất đoán đúng.
Xác suất biết nhưng trả lời sai do nhầm lẫn.
Output không nên là weak: true, mà là:
Ví dụ quy ước:
< 0.40: cần củng cố nền tảng.
0.40–0.70: đang phát triển.
0.70–0.85: luyện thêm để ổn định.
> 0.85: thành thạo tạm thời, cần ôn cách quãng.
Ngưỡng phải được hiệu chuẩn bằng dữ liệu thực tế, không coi các con số trên là chuẩn phổ quát. Nếu evidence quá ít hoặc confidence thấp, hệ thống nên đưa thêm câu chẩn đoán thay vì kết luận.
Bước 4: Phân tích lỗi, không chỉ đúng/sai
Diagnostic Agent nhận rubric, đáp án, lời giải của học sinh và lịch sử liên quan. Nó phân loại:
Thiếu kiến thức prerequisite.
Misconception cụ thể.
Lỗi thủ tục/tính toán.
Đọc sai yêu cầu.
Đáp án đúng nhưng giải thích chưa đủ.
Câu hỏi hoặc rubric có khả năng lỗi.
Output có schema:
Tên học sinh, câu trả lời tự do và nội dung tải lên là dữ liệu không tin cậy. Không cho chúng thay đổi system prompt, gọi tool hoặc truy cập dữ liệu của người khác.
Bước 5: Planner Agent tạo lộ trình khả thi
Planner không chỉ chọn skill yếu nhất. Nó tối ưu nhiều ràng buộc:
Prerequisite phải được xử lý trước.
Mỗi phiên có giới hạn thời gian và tải nhận thức.
Xen kẽ review, ví dụ mẫu, luyện có hướng dẫn và luyện độc lập.
Dùng spaced repetition cho kiến thức đã học.
Có lựa chọn tiếp cận phù hợp: văn bản, hình ảnh, audio hoặc manipulatives.
Không khóa học sinh vào một “level” cố định.
Ví dụ output:
Bước 6: Sinh bài tập bằng retrieval + generation
Ưu tiên lấy tài liệu từ kho đã duyệt. LLM chỉ:
Tạo biến thể từ template được kiểm chứng.
Điều chỉnh số liệu/ngữ cảnh nhưng giữ mục tiêu kỹ năng.
Viết gợi ý theo nhiều mức.
Chuyển đổi định dạng hoặc độ khó.
Tạo lời giải từng bước và rubric nháp.
Không để generator tự xuất bản. Verifier phải kiểm tra:
Có đúng skill và prerequisite không?
Đề có đủ dữ kiện và chỉ có đáp án hợp lệ không?
Lời giải có khớp đáp án không?
Difficulty có phù hợp estimate không?
Nội dung có thiên kiến, không phù hợp lứa tuổi hoặc chứa PII không?
Có trùng quá gần câu trong test hay làm lộ đáp án đánh giá không?
Với Toán/code, dùng solver hoặc unit test độc lập. Với câu tự luận, dùng rubric và sample answer; những trường hợp confidence thấp chuyển giáo viên duyệt.
Bước 7: Vòng lặp thích ứng
Trong production, mỗi bước nên có timeout, retry hữu hạn, tracing, model/version ID và fallback. Nếu LLM lỗi, học sinh vẫn nhận được nội dung đã duyệt từ item bank.
Bước 8: Adaptive testing không biến thành “bẫy khó dần”
Có thể dùng Item Response Theory (IRT) để ước lượng ability và chọn câu có độ khó cung cấp nhiều thông tin. Tuy nhiên:
Phải có item pool đủ lớn và đã hiệu chuẩn.
Tránh lặp quá nhiều một dạng câu.
Bảo đảm coverage chương trình.
Có stopping rule theo độ chính xác, không chỉ theo số câu.
Theo dõi differential item functioning để phát hiện item bất công.
Không dùng generated item chưa thử nghiệm cho bài thi có hệ quả cao.
IRT phù hợp đo ability trong test; Knowledge Tracing phù hợp theo dõi mastery qua chuỗi hoạt động. Hai mô hình bổ trợ nhau, không thay thế lẫn nhau.
Bước 9: Quyền riêng tư và an toàn cho học sinh
Dữ liệu giáo dục, đặc biệt của trẻ vị thành niên, cần bảo vệ nghiêm ngặt:
Pseudonymize ID; tách danh tính khỏi event học tập.
Mã hóa khi truyền/lưu, phân quyền theo vai trò và tenant.
Không gửi tên, email, disability, hồ sơ kỷ luật hoặc dữ liệu gia đình vào prompt nếu không cần.
Đặt retention và quy trình xóa/export rõ ràng.
Không dùng dữ liệu học sinh để train model bên ngoài nếu chưa có cơ sở pháp lý và đồng ý phù hợp.
Audit mọi truy cập, recommendation và override.
Tuân thủ luật áp dụng như FERPA, COPPA, GDPR hoặc quy định địa phương; cần tư vấn pháp lý cho bối cảnh triển khai.
UNESCO khuyến nghị cách tiếp cận lấy con người làm trung tâm, bảo vệ dữ liệu, phù hợp độ tuổi và thẩm định đạo đức/sư phạm trước khi dùng GenAI trong giáo dục.[1]
Bước 10: Teacher dashboard và khả năng giải thích
Giáo viên cần thấy:
Mastery theo skill cùng confidence và số bằng chứng.
Câu nào dẫn tới chẩn đoán.
Lộ trình được đề xuất và lý do.
Nội dung nào do AI tạo, model/version nào.
Nút approve, edit, reject và “không dùng AI cho học sinh này”.
Cảnh báo khi estimate thiếu dữ liệu hoặc thay đổi bất thường.
Không hiển thị nhãn tiêu cực như “học sinh yếu”. Dùng ngôn ngữ phát triển: “kỹ năng đang cần thêm bằng chứng/luyện tập”.
Đánh giá hệ thống
Offline
Calibration: nhóm dự đoán mastery 0.8 có trả lời đúng khoảng 80% ở lần sau không?
AUC/log loss cho dự đoán kết quả tiếp theo.
Precision của diagnosis so với giáo viên.
Coverage, duplication, độ khó và correctness của bài sinh.
Fairness theo các nhóm chỉ khi việc phân tích có cơ sở pháp lý và bảo vệ phù hợp.
Online
Learning gain qua pre-test/post-test.
Thời gian để đạt mastery, retention sau 1–4 tuần.
Tỷ lệ hoàn thành và yêu cầu trợ giúp.
Tải review của giáo viên.
Tỷ lệ override và khiếu nại.
Không tối ưu engagement đơn thuần. Thời gian dùng app dài hơn không đồng nghĩa học tốt hơn. A/B test nên có guardrail về fairness, stress và khối lượng học.
Lộ trình triển khai
Giai đoạn 1 — Rules + item bank
Một môn, một khối lớp, 20–50 skill.
Câu hỏi và lời giải do giáo viên duyệt.
Mastery rule minh bạch.
AI chỉ tóm tắt chẩn đoán cho giáo viên.
Giai đoạn 2 — Knowledge Tracing
BKT/IRT được hiệu chuẩn.
Planner đề xuất lộ trình nhưng cần duyệt.
Dashboard hiển thị confidence và evidence.
Giai đoạn 3 — Controlled generation
Sinh từ template và nguồn vetted.
Verifier độc lập; sampling kiểm định thủ công.
Chỉ auto-publish bài low-risk đạt ngưỡng chất lượng.
Giai đoạn 4 — Adaptive orchestration
Điều chỉnh theo thời gian thực.
Spaced repetition và multi-modal resources.
Thử nghiệm có đối chứng trước khi mở rộng.
Checklist production
Skill graph và curriculum version do chuyên gia sở hữu
Item/rubric versioning và audit trail
Mastery có confidence, evidence count và fallback
LLM không trực tiếp quyết định điểm số có hệ quả cao
Generated content qua verifier và teacher policy
Prompt/input/output được lọc PII và cô lập tenant
Consent, retention, deletion và access control rõ ràng
Accessibility và age-appropriate design
Fairness, calibration và learning gain được đo
Human override, incident response và kill switch
Kết luận
AI Agent tạo lộ trình học hiệu quả phải bắt đầu từ đo lường giáo dục, không phải từ prompt. Skill graph và item bank cung cấp nền tảng; Knowledge Tracing cho biết mức độ thành thạo và độ chắc chắn; Planner chọn bước tiếp theo; LLM tạo nội dung trong phạm vi; Verifier cùng giáo viên bảo đảm chất lượng. Khi vòng lặp này minh bạch, có bằng chứng và bảo vệ dữ liệu, cá nhân hóa mới thực sự phục vụ việc học thay vì chỉ tạo ra nhiều nội dung hơn.
Hướng dẫn xây hệ thống điểm danh bằng QR động hoặc nhận diện khuôn mặt, tập trung chống gian lận, liveness, quyền riêng tư, audit và triển khai an toàn.
Hướng dẫn xây trợ lý học tập AI 24/7 với RAG, vector database, semantic search, citation verification, chống hallucination, bảo mật tài liệu và đánh giá chất lượng.
Tự xây AI Coding Agent cho Cursor và VS Code bằng TypeScript: kiến trúc agent loop, code review, sandbox chạy test, GitHub App và tạo draft Pull Request an toàn.